day15 数据结构
时间复杂度和空间复杂度
- 定义:时间复杂度和空间复杂度是衡量算法效率的两个指标。理解算法的时间复杂度和空间复杂度对于优化算法,提高程序效率非常重要。
- 时间复杂度:是指算法运行所需时间随输入规模增加而增加的速度,通常用大 O 记法来表示。例如,O(n) 表示算法的运行时间与输入规模 n 成线性关系,O(n^2) 表示算法的运行时间与 n 的平方成比例。
- 空间复杂度:是指算法所需内存空间随输入规模增加而增加的速度,也用大 O 记法来表示。例如,O(1) 表示算法的空间复杂度为常数,不随输入规模变化,O(n) 表示算法的空间复杂度随着输入规模线性增加。
/**
 * @Description 时间复杂度计算方式
 * 在这个例子中,我们定义了一个名为sum的方法,该方法接受一个整数n作为参数,并返回1到n的总和。我们使用for循环计算总和,因此该算法的时间复杂度为O(n)。
 * 在main方法中,我们调用sum方法,并使用System.nanoTime()方法来测量方法的执行时间。最后,我们打印出方法的返回结果和执行时间。
 * @Author Noby
 * @Date 2023/3/17
 */public class TimeComplexityNote {
    public static void main(String[] args) {
        int n = 10000;
        long startTime = System.nanoTime();
        int result = sum(n);
        long endTime = System.nanoTime();
        long time = endTime - startTime;
        System.out.println("sum(" + n + ") = " + result);
        System.out.println("Time taken: " + time + " nanoseconds");
    }

    static int sum(int n) {
        int result = 0;
        for (int i = 1; i <= n; i++) {
            result += i;
        }
        return result;
    }
}
/**
 * @Description 空间复杂度的计算方式
 * @Author Noby
 * @Date 2023/3/17
 */public class SpaceComplexityNote {
    public static void main(String[] args) {
        System.out.println("fibonacci(7) = " + fibonacci(7));
    }

    /**
     * 采用递归计算斐波那契数列
     * 这个算法的空间复杂度为O(n),因为它需要n个函数调用的栈空间来存储参数和返回地址。如果使用尾递归优化,空间复杂度可以优化为O(1)。
     * 斐波那契数列是指这样一个数列:0、1、1、2、3、5、8、13、21、34、……在数学上,斐波那契数列以递推的方式定义:
     * F(0) = 0
     * F(1) = 1     * F(n) = F(n-1) + F(n-2) (n ≥ 2,n ∈ N*)
     * @param n
     * @return
     */
    static int fibonacci(int n) {
        if (n <= 1) {
            return n;
        }
        return fibonacci(n-1) + fibonacci(n-2);
    }
}
栈和队列
- 定义: 栈和队列都是常用的数据结构。栈是一种后进先出(Last-In-First-Out, LIFO)的数据结构,类比于一个弹夹或箱子,只能从顶部插入和删除元素。队列是一种先进先出(First-In-First-Out, FIFO)的数据结构,类比于排队等待的人群,只能从队列的一端插入元素,从另一端删除元素。在 Java 中,栈可以使用 Stack 类或者 Deque 接口来实现。队列可以使用 Queue 接口来实现,其中最常用的实现类是 LinkedList。
package note;

import java.util.LinkedList;
/**
 * @Description 实现队列和栈的数据结构
 * @Author Noby
 * @Date 2023/3/16 19:38
 */public class LinkedListNote2 {
    public static void main(String[] args) {
        LinkedList<String> strings = new LinkedList<>();
        //region 栈:先进后出。push()(添加到第一个,没有返回值)和pop()(删除第一个,返回被删除的值)方法继承自Deque(双端队列)
        strings.push("one");
        strings.push("two");
        strings.push("three");
        System.out.println("strings = " + strings);//strings = [three, two, one]
        System.out.println("strings.pop() = " + strings.pop());//strings.pop() = three

        System.out.println("strings = " + strings);//strings = [two, one]
        //endregion
        strings.clear();

        //region 队列:先进先出。offer()(添加到最后一个,返回boolean),poll()(删除第一个,返回删除对象),方法继承自Queue(队列)的方法,Queue实现了Deque
        System.out.println("strings.offer(\"one\") = " + strings.offer("one"));//strings.offer("one") = true
        System.out.println("strings.offer(\"two\") = " + strings.offer("two"));//strings.offer("two") = true
        System.out.println("strings.offer(\"three\") = " + strings.offer("three"));//strings.offer("three") = true
        System.out.println("strings = " + strings);//strings = [one, two, three]
        System.out.println("strings.poll() = " + strings.poll());//strings.poll() = one

        System.out.println("strings = " + strings);//strings = [two, three]
        //endregion    }
}
链表
单链表
在每一个节点中,data 负责保存数据,而 next 用于保存下一个节点的地址(引用),这样多个节点就组成了一个链,我们称之为链表。

相较于数组链表在增删数据方面效率要高一些,插入数据时只需要将上一个节点的 next 执行新节点,新节点的 next 指向后一个节点。

在删除节点时只需要将前一个节点的 next 执行要删除节点的后一个节点就行

但是单链表也有自己的缺点:遍历速度较慢。
因为单链表不像数组空间是连续的,链表中的节点分散在内存中不同的位置,不管想要得到哪个元素都必须从链表的头节点找起,故而影响到了查询效率。
双链表 (LInkedList 为该结构,java 中的所有链表都是基于双向链表)
为了解决单链表查询效率较慢的问题,双链表由此诞生。双链表的基本组成单元也是节点,但与单链表节点不同的是双链表的节点多了一个指向前一个节点的引用,因此通过任何一个节点都可以找到其后一个节点及前一个节点,寻找数据时也就不需要非得从头开始。
多个节点串联在一起就组成了双链表:

树
- 定义:在数据结构中,树 (Tree) 是一种非线性数据结构,它由节点(Node)和边(Edge)组成,节点之间通过边相连,形成一个层次关系。树的顶部节点被称为根节点(Root),树中除了根节点外的每个节点都有且仅有一个父节点(Parent),而一个节点可以有零个或多个子节点(Children)。树的一个重要特点是,它没有环(Cycle),即节点之间不能形成环路。
2-3 树
- 定义:2-3 树,是指每个具有子节点的节点(内部节点,internal node)要么有两个子节点和一个数据元素,要么有三个子节点和两个数据元素的自平衡的树,它的所有叶子节点都具有相同的高度。
- 特点
- 满足二叉搜索树的性质。
- 节点可以存放一个或两个元素
- 每个节点有两个或三个子节点

2-3-4 树
- 定义:2-3-4 树,它的每个非叶子节点,要么是 2 节点,要么是 3 节点,要么是 4 节点,且可以自平衡,所以称作 2-3-4 树。
- 特点
- 满足二叉搜索树的性质。
- 节点可以存放一个、两个或三个元素
- 每个节点有两个、三个或四个子节点

二叉树
- 定义:二叉树是一种树形数据结构,它由一个根节点和最多两个子树(左子树和右子树)构成,其中左子树和右子树也都是二叉树。二叉树的节点最多有两个子节点,一个是左子节点,一个是右子节点,而且左子节点的值小于父节点的值,右子节点的值大于等于父节点的值。二叉树可以用于排序、查找、遍历等操作,常见的二叉树包括二叉搜索树、平衡二叉树、完全二叉树等。

- 左子树:每个节点左边所有的节点
- 右子树:每个节点游遍所有的节点
- 根节点:所有节点的父节点
- 叶子节点:没有子节点的节点
遍历方式
- 层序遍历:从上到下,从左到右
- 先序遍历 (先根遍历):先遍历根节点,然后遍历左子树,最后遍历右子树
- 中序遍历:先遍历左子树,然后遍历根节点,最后遍历右子树
- 后序遍历:先遍历左子树,然后遍历右子树,最后遍历根节点

- 层序遍历 10、6、8、12、3、4
- 先序遍历 (先根遍历) 10、6、3、8、12、15
- 中序遍历 3、6、8、10、12、15
- 后序遍历 3、8、6、15、12、10
排序二叉树
- 排序二叉树(Sorted Binary Tree),也称为二叉查找树(Binary Search Tree),也称为二叉搜索树、有序二叉树(ordered binary tree)。是一种非常通用的术语,它可以用来指代任何一种满足以下条件的二叉树:
- 所有左子树上的节点的值都小于根节点的值。
- 所有右子树上的节点的值都大于根节点的值。
- 排序二叉树存在的问题:数据倾斜带来遍历效率下降,形成退化。例如在插入 5/6/7/8/9 这几个数据时会造成以下问题。如图,可以看到此时排序二叉树其实已经变成了一个连表,使得遍历的效率大大降低,为了解决这个问题平衡二叉树诞生了。

平衡二叉树
- 平衡二叉树(Balanced Binary Tree)是一种特殊的排序二叉树,它的左右子树的高度差不超过 1。也就是说,平衡二叉树保证了树的高度不会过高,从而保证了插入、删除和查找等操作的时间复杂度为 O(log n)。
- 常见的平衡二叉树包括红黑树、AVL 树和 B 树等。其中,红黑树是一种高效的平衡二叉树,被广泛应用于 STL 中的 map 和 set 等容器的实现中。AVL 树是另一种平衡二叉树,它在平衡性方面比红黑树更加严格,但是在实际应用中由于其旋转操作较多,导致速度较慢。
- 平衡二叉树的实现通常需要维护节点的平衡因子,即左右子树的高度差。当插入或删除节点后,如果某个节点的平衡因子超过了 1,则需要通过旋转操作来重新平衡树。


平衡二叉树是一种自平衡二叉树,主要是通过数的左旋右旋来实现平衡的。具体来说,如果左子树的高度大于右子树的高度,则需要进行右旋转;如果右子树的高度大于左子树的高度,则需要进行左旋转。如果左子树的右子树的高度大于左子树的左子树的高度,则需要先对左子树进行左旋转,再对当前节点进行右旋转;如果右子树的左子树的高度大于右子树的右子树的高度,则需要先对右子树进行右旋转,再对当前节点进行左旋转。
- 当新插入数据时造成的树的不平衡,将会左旋:


- 当新插入数据时不会造成的树的不平衡,将不会旋转:

- 继续添加 9,此时二叉树不平衡,需要发生旋转


- 插入 10,当插入 10 时有需要进行旋转,只不过此时不再是围绕着 9 旋转,因为围绕 9 旋转的结果并不会让树保持平衡,那么就会再向上寻找一个节点,判断围绕该节点旋转能不能得到平衡,如果可以则围绕着该节点进行旋转。下图所示围绕 8 旋转之后能得到平衡,将 5 和 6 旋转成 8 的左子树,将 7 断开与 8 的连接,然后将 7 作为 6 的右子树


继续插入 11,此时 9 的左子树与右子树树高相差超过 1 不平衡,需要发生旋转


右旋:右旋逻辑跟左旋是一样的,只不过是换了一个方向,此处就不再详细解释了
平衡二叉树的缺点:插入数据时经常会频繁的进行左旋、右旋使得数的维护非常麻烦,而且严重消耗性能。为了减少旋转红黑树诞生了
红黑树
红黑树(Red-Black Tree)是一种自平衡的二叉搜索树,也是一种平衡二叉树。它在二叉搜索树的基础上,增加了额外的颜色属性,每个节点为红色或黑色。红黑树具有以下特点:
- 每个节点要么是黑色,要么是红色。
- 根节点是黑色的。
- 每个叶子节点(NIL 节点,空节点)是黑色的(注意:图中没画出叶子节点,它是空的)。
- 如果一个节点是红色的,则它的子节点必须是黑色的。
- 从任意一个节点到其每个叶子节点的所有路径都包含相同数目的黑色节点。

这些特点保证了红黑树的平衡性,使得其在插入、删除、查找等操作的时间复杂度上有较好的保证。红黑树的实现相对复杂,但是由于其优秀的性能表现,被广泛应用于计算机科学中。
红黑树和 2-3-4 树 的转换

红黑树的插入步骤(技巧:红色在满足 4 和 5 条件的同时接近叶子节点,新插入的为红色)
插入 7 时,黑不平衡,发生旋转


插入 8,将 5 和 7 变为黑,达到黑平衡,不需要旋转

- 插入 9,黑不平黑发生旋转


- 插入 10,黑平衡,不需要旋转

- 插入 11,黑不平衡,需要旋转


- 插入 12,围绕 8 进行旋转


哈希表
- 数组:采用一段连续的存储单元来存储数据。对于指定下标的查找,时间复杂度为 O(1);通过给定值进行查找,需要遍历数组,逐一比对给定关键字和数组元素,时间复杂度为 O(n),当然,对于有序数组,则可采用二分查找,插值查找,斐波那契查找等方式,可将查找复杂度提高为 O(log n);对于一般的插入删除操作,涉及到数组元素的移动,其平均复杂度也为 O(n)
- 线性链表:对于链表的新增,删除等操作(在找到指定操作位置后),仅需处理结点间的引用即可,时间复杂度为 O(1),而查找操作需要遍历链表逐一进行比对,复杂度为 O(n)
- 二叉树:对一棵相对平衡的有序二叉树,对其进行插入,查找,删除等操作,平均复杂度均为 O(logn)。
- 哈希表:相比上述几种数据结构,在哈希表中进行添加,删除,查找等操作,性能十分之高,不考虑哈希冲突的情况下(后面会探讨下哈希冲突的情况),仅需一次定位即可完成,时间复杂度为 O(1),接下来我们就来看看哈希表是如何实现达到惊艳的常数阶 O(1) 的。
数据结构的物理存储结构只有两种:顺序存储结构和链式存储结构(像栈,队列,树,图等是从逻辑结构去抽象的,映射到内存中,也这两种物理组织形式),而在上面我们提到过,在数组中根据下标查找某个元素,一次定位就可以达到,哈希表利用了这种特性,哈希表的主干就是数组。
底层实现原理
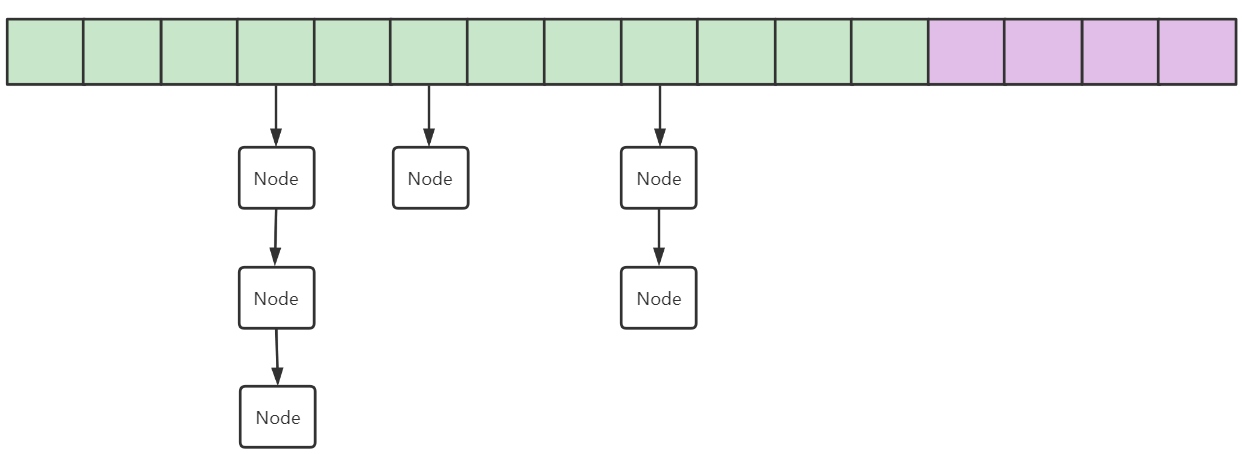
HashMap 底层是由数组、连表/红黑树实现的。
- 节点:hashmap 中每个 node 节点存储着 k,v,和根据 key 通过 hashcode() 的算出的 hash 值,以及下一个节点的地址
- 数组:该数组在 hashmap 中叫做桶数组,初始长度为 16,负载因子为 0.75,当其长度为原来的 0.75 倍时扩容为原来的两倍
- 数组中存储链表:链表数据结构的时间复杂度高,空间复杂度低,链表转红黑树条件为数组长度超过 64,链表长度大于 8
- 数组中存储红黑树:红黑树数据结构的时间复杂度低,空间复杂度高
- hashmap 是一个无序的,键不可重复的双列集合,他通过键值对的方式存储数据,hashmap 中的作为内部类 node 节点存储着 k,v,和根据 key 通过 hashcode() 的算出的 hash 值,以及下一个节点的地址,在 jdk1.8 中,hashmap 存储数据的方式是哈希表 数组 + 链表 + 红黑树 的组合形势,这里的数组通常称为桶数组,它的初始长度为 16,负载因子为 0.75,当通数组使用容量达到当前最大容量的 0.75 倍时,将进行当前最大容量乘以 2 的方式扩容。当添加一对键值对时,通过键计算出其 hash 值,通过 hash 值以及位运算计算出桶数组的索引,节点存储在该桶数组的索引位置,当该索引位置已经存在其他节点时,将通过 equals() 方法判断该节点的键是否已存在的节点的键相同,当键相同时,覆盖原有节点的 value 值,当键不同时,通过与最后一个节点以链表的形势进行数据关联,当链表的长度大于 8,数组的长度大于 64 时,会将链表的结构转换为红黑树,该过程是为了降低数据查询过程的时间复杂度,而当数据的长度小于 6 时,会将红黑树的结构转换为重新链表,而这里大于 8 转换由链表转换为红黑树,小于 6 由红黑树转换为链表,他们的临界值不同的原因在与避免当数据的容量因为节点的增加或修改在 6 或 8 徘徊时,频繁的在红黑树和链表之间来回转换,因为转换过程相对来说运行的速度比较慢,hashmap 设计的这种红黑树和链表并存,通过数据的容量相互转换的原因在于在程序的内存占用和时间效率做一个平衡。